Lektion 2 Der erweiterte Workflow
Wenn Sie alle Schritte in Lektion 1 abgeschlossen haben, sind Sie bereit, zur nächsten Stufe überzugehen. Lektion 2 führt Sie über die Grundlagen hinaus in den Kern der fortgeschrittenen Funktionalität der Plattform.
Hier lernen Sie Generische IoT-Nodes und Netzwerkprotokolle, CSV-Reporting, Organisationen, OEM-Branding, Rollen, Connectors, Externe Datenfreigabe und Data Flows kennen. Jeder Abschnitt enthält optionale Vertiefungslektionen, um Ihr Verständnis zu stärken und diese Funktionen in realen Szenarien anzuwenden.
💡 Tipp: Neue Plattformfunktionen sind oft schon in der Backend-API verfügbar, bevor sie in der Weboberfläche erscheinen.
Um auf die neueste Funktionalität zuzugreifen, ist es wertvoll, mit der Swagger-API-Schnittstelle vertraut zu sein, mit der Sie jeden Aspekt der Plattform konfigurieren und verwalten können – noch bevor volle UI-Unterstützung eingeführt wird.
Schritt 1 - Benachrichtigungen über die Regelmotor hinzufügen
Regeln
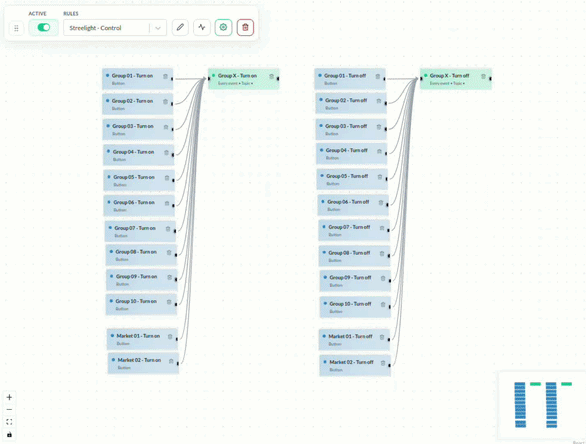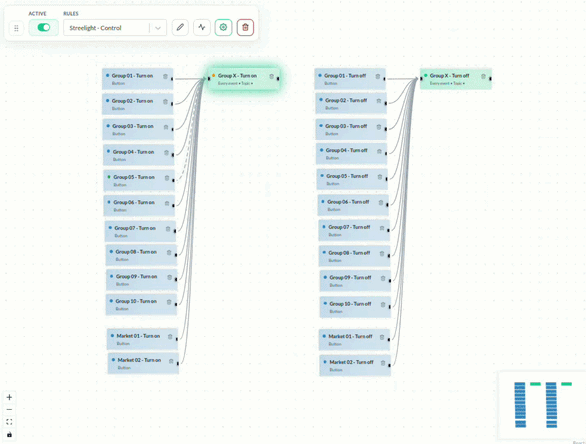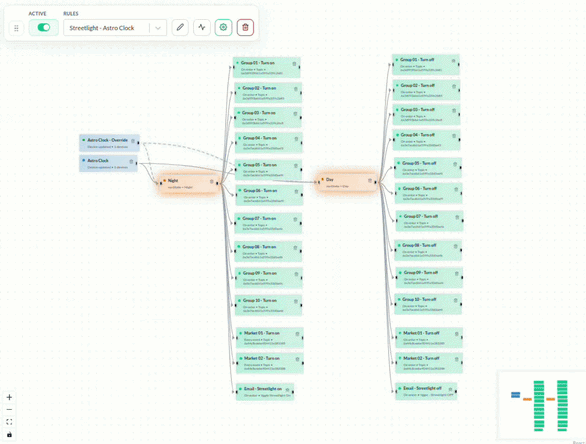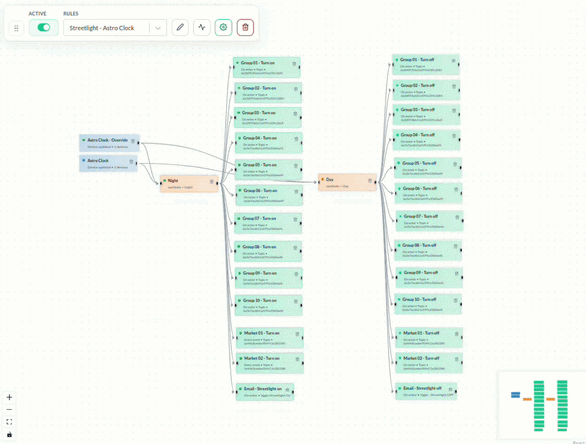
Regeln werden durch vordefinierte oder benutzerdefinierte Bedingungen ausgelöst. Eine übliche Anwendung ist die Überprüfung von Schwellenwerten oder die Verifizierung, dass Geräte wie erwartet melden. Dies dient in der Regel dazu, Benachrichtigungen zu senden, wenn etwas Wichtiges passiert.
Beginnen wir mit der Schwellenwertüberwachung. Sie möchten zum Beispiel eine E-Mail-Benachrichtigung erhalten, wenn es draußen 25 °C sind, damit Sie wissen, dass es Zeit ist, rauszugehen, oder eine Warnung, wenn ein sich bewegendes Gerät einen Geofence-Bereich verlässt. Im vorherigen Schritt haben Sie bereits einen Übersetzer hinzugefügt, um diese Schwellenwerte zu überwachen. Jetzt verbinden Sie die Ausgabe dieses Übersetzers, um eine Regel auszulösen.
Sie fügen einem Gerät einen Trigger und eine Condition hinzu – und wenn diese Bedingung erfüllt ist, wird eine Action Ihrer Wahl ausgelöst. Dies kann alles Mögliche sein, vom Senden einer E-Mail bis zum Ausführen eines Befehls. All dies wird in der Rule Engine verwaltet, die im Menü Apps zu finden ist.
Mehr erfahren
- Rule-Engine-Dokumentation: hier
- Legacy-Rule-Engine-Dokumentation: hier
- Rule Engine Report Generator Dokumentation: hier
- Schulungsmaterial Rule Engine: Rule Engine
- Schulungsmaterial Legacy Rule Engine: Rule Engine (Legacy)
Schritt 2 - Berechnungen und aggregierte Messwerte
Berechnete Nodes ermöglichen es Ihnen, Aggregationen durchzuführen und aussagekräftige Werte aus Ihren IoT-Daten abzuleiten – wie die durchschnittliche, maximale oder minimale Temperatur in einem Gebäude, oder wie schnell sich Werte im Laufe der Zeit ändern. Sie werden häufig verwendet, um Daten aus mehreren Quellen zusammenzufassen, wie Füllstandssensoren, Energiezähler oder Wasserzähler, und sind eine leistungsstarke Möglichkeit, KPIs (Key Performance Indicators) zu generieren, die in Dashboards oder Reports visualisiert werden können.
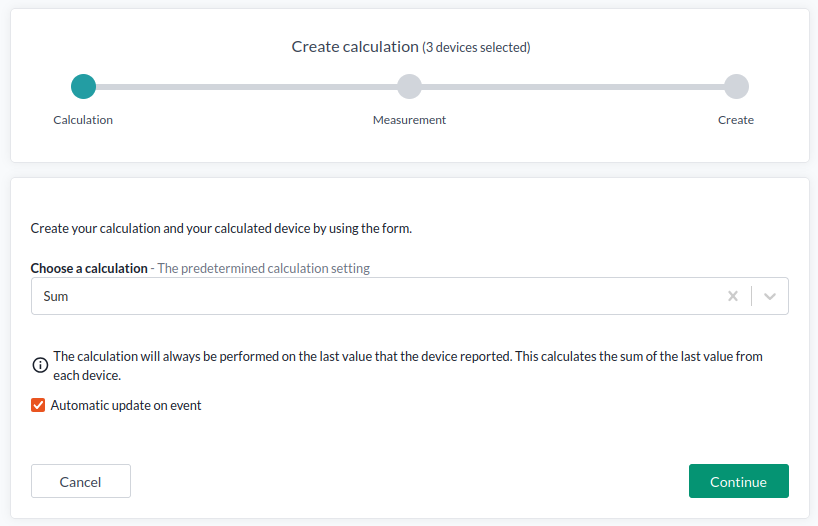
Eine Berechnung pro Node – oder mehr?
Standardmäßig enthält jeder berechnete Node einen einzigen berechneten Messwert. Wenn Sie jedoch über die API arbeiten, können Sie einem einzelnen IoT-Node mehrere Berechnungen zuweisen. Dies ist besonders nützlich in fortgeschrittenen Anwendungsfällen, in denen mehrere KPIs aus demselben Satz von Eingabedaten benötigt werden – zum Beispiel bei der Generierung von Reporting-Metriken oder der Erstellung einer Multi-Metrik-Ansicht.
Wann Berechnungen nicht verwendet werden sollten
Wichtig: Berechnungen eignen sich nicht gut für Fälle, in denen Logik oder Bedingungen auf eingehende Daten angewendet werden müssen, bevor die Aggregation erfolgt. Verwenden Sie für diese Szenarien einen Data Flow, wie ein Additional Device Update über einen angepassten Übersetzer.
Beispiele, bei denen Data Flows besser geeignet sind:
- Herausfiltern ungültiger oder verrauschter Daten vor der Aggregation
- Durchführen bedingter Berechnungen (z. B. Werte nur summieren, wenn ein Status "active" ist)
- Anwenden von Einheitenumrechnungen oder Normalisierung vor der Aggregation
Mehr erfahren, einschließlich Beispielanwendungsfällen
- Schulungsmaterial Berechnungen
- Benutzerhandbuch Berechnungen: hier
Schritt 3 - Der generische Gerätetyp: IoT-Nodes und Netzwerkprotokolle (von NB-IoT bis BLE)
In dieser Lektion behandeln wir, wie man IoT-Geräte basierend auf ihrem Transportprotokoll zur Plattform hinzufügt, wobei die meisten Geräte über den vielseitigen Gerätetyp Generic erstellt werden.
Wir werden auch die zugrunde liegenden physikalischen und Netzwerktechnologien für jedes Protokoll untersuchen, um die Kommunikation über MQTT, HTTP, TCP, UDP, CoAP und andere gängige Schnittstellen zu verstehen. Abschließend skizzieren wir, wie diese Kommunikation mithilfe von Zertifikaten oder Ende-zu-Ende-Verschlüsselungsmethoden wie OSCORE gesichert werden kann.
Ein IoT-Node repräsentiert nicht immer ein physisches Gerät – er kann auch ein logisches oder virtuelles Element sein, das für Datenfluss-Steuerung oder Zugriffsverwaltung verwendet wird. Zum Beispiel kann ein Geofence-Node die Anzahl der Assets zählen, die definierte Bereiche betreten und verlassen, oder helfen, den Datenzugriff nach Rolle zu trennen.
Es gibt drei Haupttypen von IoT-Nodes:
- Geräte: Repräsentieren physische Endpunkte, typischerweise Sensoren oder Aktuatoren. Diese erfordern normalerweise einen gerätespezifischen Übersetzer, um eingehende, komprimierte oder kodierte Daten zu dekodieren.
- Virtuelle Nodes: Logische Nodes, die einen Zustand halten oder physische Geräte indirekt repräsentieren – wie Geofences, WLAN-Beacons, berechnete Nodes oder simulierte Geräte.
- Dienste: Nodes, die Daten von externen Diensten wie OpenWeatherMap oder Nordpool empfangen oder bereitstellen (z. B. Energiepreise, Wettervorhersagen).
Werfen wir einen genaueren Blick darauf, wie die horizontale Integration von IoT-Geräten innerhalb der Plattform funktioniert, mit Fokus auf den Gerätetyp Generic, der mehrere Protokolle und Konnektivitätsebenen unterstützt.
- Anwendungsprotokolle wie HTTP, MQTT und CoAP definieren, wie Geräte Daten mit der Plattform austauschen, abhängig von ihren Fähigkeiten und Ressourcenbeschränkungen.
- Transportprotokolle - TCP und UDP - transportieren diese Anwendungsnachrichten. TCP sorgt für Zuverlässigkeit (verwendet von HTTP, MQTT und LwM2M über TCP), während UDP Effizienz für ressourcenbeschränkte Geräte ermöglicht (verwendet von CoAP, rohem UDP und LwM2M über UDP).
- Die Netzwerkschicht (IP) verwaltet Adressierung und Routing und stellt sicher, dass die Kommunikation unabhängig vom zugrunde liegenden Medium funktioniert.
- Die Link-/Physical-Schicht umfasst Technologien wie Ethernet, WLAN, LTE/NB-IoT/LTE-M/5G, LoRaWAN und Kurzstreckenprotokolle wie Bluetooth/BLE, Z-Wave und ZigBee.
Mehr erfahren
- Schulungsmaterial über Generische IoT-Nodes und Netzwerkprotokolle
💡 Dies ist eine der wichtigsten Lektionen des Schulungsmaterials.
Zu verstehen, wie verschiedene IoT-Geräte kommunizieren – von der physikalischen Schicht bis zur Anwendungsschicht – ist essenziell, um Geräte in der Plattform erfolgreich zu integrieren und zu verwalten.
Schritt 4 - CSV-Reports
Das System unterstützt mehrere Arten von Reports:
- CSV-Export-Reports (E-Mail oder Direkt-Download): Diese Reports enthalten nur die Rohdaten im CSV-Format. CSV-Daten können auch direkt aus jeder Device View und aus Charts exportiert werden.
- Geräteliste-Views als CSV-Dateien exportieren: Eine der einfachsten Möglichkeiten, die Live-Daten einer View zu exportieren, ist der Export als CSV-Dateien über Select Many
- Geräte-Zeitreihendaten als CSV-Dateien exportieren: Exportieren Sie alle Daten einer Chart-Ansicht direkt in eine CSV-Datei.
Mehr erfahren
- Schulungsmaterial zum Erstellen von einfachen Reports
Schritt 5 - Excel-Reports
Excel-Reports sind der leistungsstärkste und flexibelste verfügbare Report-Typ. Sie unterstützen eine sehr große Menge an Datenpunkten pro Report und können die volle Leistung von Excel-Formeln, -Funktionen und -Visualisierungen nutzen. Sie können entweder die Standardreports "wie sie sind" wiederverwenden, ihre Report Base ändern, um die benötigten Daten zu extrahieren, oder einen vollständig benutzerdefinierten Report erstellen.
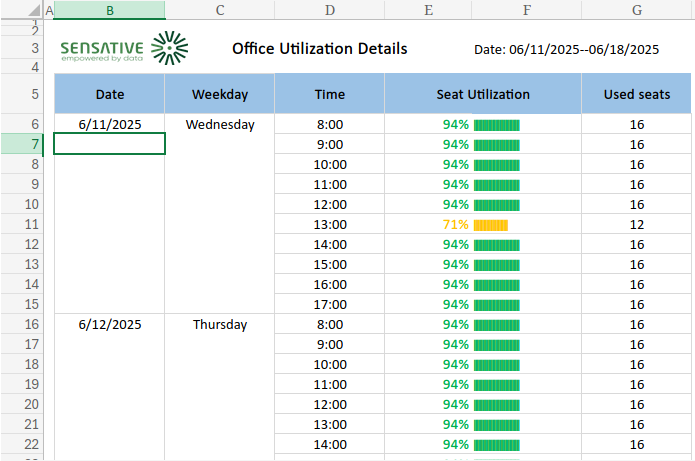
So funktioniert es:
- Beginnen Sie mit einem Standardreport oder erstellen Sie Ihre eigene Excel-Vorlage mit Formeln, Diagrammen und Layout.
- Laden Sie die Vorlage auf Yggio hoch, wenn Sie einen der Standardreports geändert haben.
- Wenn der Report generiert wird, befüllt Yggio die Vorlage mit Zeitreihen- und IoT-Node-Rohdaten.
- Excel-Formeln berechnen automatisch die finalen KPIs, Aggregationen und Visualisierungen.
- Vor der Auslieferung entfernt Yggio alle Formeln und erstellt einen sauberen, statischen Report für die Vorschau oder den E-Mail-Versand.
- Vorschau und Download des Reports, alternativ einen Zeitplan einrichten und automatisch an Empfänger verteilen lassen.
Excel-Reports eignen sich ideal für erweitertes Reporting, regulatorische Compliance, kundenorientierte Zusammenfassungen oder alles, wo Präsentation und Datenverarbeitung zusammenkommen müssen.
Mehr erfahren
- Erstellen Sie Excel-Reports mit den Vorlagen unter Standardreports.
- Erfahrene Excel-Benutzer und Entwickler, die mehr Kontrolle über Excel-Reports wünschen, sollten sich Custom Reports ansehen.
Schritt 6 - Organization Manager
Benutzer auf der Plattform können Ressourcen auf drei Arten teilen:
- Über den Organization Manager – Richten Sie eine Hierarchie ein und wenden Sie entsprechende Freigaberichtlinien an.
- Direkte Freigabe von Benutzer zu Benutzer – Teilen Sie bestimmte Ressourcen mit einzelnen Benutzern.
- Freigabe über Benutzergruppen – Teilen Sie Ressourcen mit einer Gruppe von Benutzern gleichzeitig.
Benutzergruppen sind besonders nützlich, um Berechtigungen für mehrere Benutzer effizient zu verwalten. Sie können die Zugriffsrechte für einen Benutzer oder eine Benutzergruppe einfach ändern – zum Beispiel direkt über das Geräte-Menü.
Teilbare Ressourcen
- IoT-Nodes
- Connectors
- Dashboards
- Reports
- Basic Credential Sets
- Geofences
- Bilder
Hinweis: Ansichten in der Device List und Map gelten nicht als teilbare Ressourcen. Sie folgen einem einfacheren Freigabemodell, da sie als persönliche Anpassungen betrachtet werden.
Ansichten sind entweder persönlich oder werden mit der gesamten Organisation geteilt. Wenn sie geteilt werden, kann nur ein Organisationsadministrator sie ändern oder entfernen.
Mehr erfahren
- Bauen Sie Ihre Organisation auf
- Direkte Freigabe und Zugriffsrechte für Benutzergruppen
- Daten teilen
Schritt 7 - Benutzerrollen
Rollen definieren, was ein Benutzer innerhalb von Yggio tun kann. Ein Benutzer kann voreingestellte Rollen (Admin, Editor, Viewer, Installer) oder eine benutzerdefinierte Rolle haben.
Die UI und die API erzwingen die durch die Rollen definierten Berechtigungen. Rollen haben nichts damit zu tun, auf welche Ressourcen der Benutzer zugreifen kann, sondern nur damit, was der Benutzer mit den Ressourcen tun kann, auf die er zugreifen kann.
Mehr erfahren
Schritt 8 - Connectors hinzufügen
Connectors sind grundlegende Komponenten, die Daten in die Plattform bringen. Sie speichern die notwendigen Zugangsdaten, URLs und Data Topics, die es Yggio ermöglichen, externe Datenquellen zu abonnieren. Das Einrichten von Connectors erfordert Zugriff auf das entfernte System und die Koordination von Zugangsdaten und Berechtigungen zwischen beiden Systemen. Da jedes externe System einzigartig ist, ist normalerweise ein gutes Verständnis dafür erforderlich, wie dieses System funktioniert.
Die meisten Connectors verwenden REST-APIs für die Ersteinrichtung und MQTT für den Empfang von Live-Datenströmen. Einige ältere IoT-Protokolle – wie BACnet und Modbus, die oft in der Gebäudeverwaltung zu finden sind – funktionieren jedoch anders.
Wenn beim Einrichten eines Connectors Probleme auftreten, können sowohl Sensative (das Plattform-Support-Team) als auch das Support-Team des entfernten Systems helfen. Sobald Connectors ordnungsgemäß konfiguriert sind, wird der Rest des Prozesses unkomplizierter.
Wofür werden Connectors verwendet?
Um Geräte zu Yggio hinzuzufügen, benötigen Sie mindestens einen Connector. Wenn noch keiner existiert, müssen Sie einen erstellen.
Connectors verbinden Yggio mit einer Vielzahl von Datenquellen, darunter:
- Öffentliche Dienste wie OpenWeatherMap
- LoRaWAN-Server
- Geräte, die über Protokolle wie MQTT, HTTP, NB-IoT, Cat M, BACnet, Modbus und mehr kommunizieren
Mehr erfahren
- Schulungsmaterial für Connectors
- Detaillierte Anweisungen zum Erstellen und Verwalten von Connectors finden Sie hier: Connectors-Übersicht.
Schritt 9 - Echtzeit- und statische Daten aus der Plattform exportieren
In dieser Lektion erkunden Sie, wie Sie Daten außerhalb der Plattform mit HTTP-Webhooks und MQTT teilen, lernen, Kanäle mit Authentifizierung zu erstellen und zu konfigurieren, veröffentlichte und abonnierte Daten mit MQTT Explorer zu überwachen, das Veröffentlichen von Daten über MQTT-Connectors an externe Systeme zu üben, und verstehen die wichtigsten Konzepte für eine sichere und zuverlässige externe Datenintegration.
In dieser Lektion lernen Sie, wie Sie Daten extern mit HTTP-Webhooks und MQTT teilen, mit Fokus auf das direkte Senden von Updates von der Plattform, ohne Zugriff auf externe Systeme zu benötigen.
Mehr erfahren
- Schulungsmaterial für Externe Datenfreigabe
- Benutzerhandbuch für Generic Integration
- Entwicklerhandbuch für MQTT Generic
Schritt 10 - Flows
Der Begriff Flow bezieht sich auf die Kombination von Data Flows und Übersetzern, die auf IoT-Nodes angewendet werden. Flows sind im Wesentlichen Sätze von Verarbeitungsanweisungen, die für bestimmte Anwendungsfälle angepasst werden können. Sie können Transform-Funktionen enthalten – benutzerdefinierte Code-Schnipsel, die auf die Plattform hochgeladen und sicher in einer Sandbox-Umgebung ausgeführt werden.
Übersetzer enthalten eine Funktion namens "Additional Device Update", mit der Teile eingehender Daten – oder die Ergebnisse von Berechnungen – an andere IoT-Nodes weitergeleitet werden können. Zusammen bilden Data Flows und Übersetzer ein leistungsstarkes Framework zur Umsetzung komplexer IoT-Anwendungsfälle, das es der Plattform ermöglicht, sogar viele Szenarien der industriellen Automatisierung zu bewältigen.
Ein Data Flow besteht aus einem Behavior Tree, der festlegt, wie und in welcher Reihenfolge eingehende Daten innerhalb der IoT-Plattform verarbeitet werden. Er bestimmt, welche Funktionalität ausgelöst wird, wenn ein IoT-Node ein Update-Ereignis empfängt.
Hinweis: Flows werden auf Legacy-Connectors unter New Device in Devices nicht unterstützt.
Standard-Flows
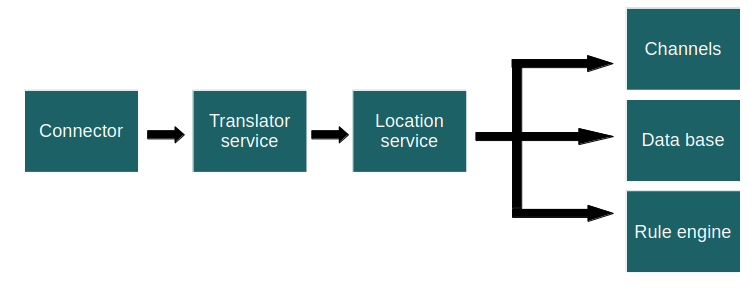
- Default Flow – Standardfunktionalität, einschließlich Translator Service, Location Service, Calculations, Rule Engine und Channels.
- General Timer – Enthält die Standardfunktionalität plus die Möglichkeit, einen eindeutigen Timer pro IoT-Node zu starten und zu stoppen.
- General Geo Query – Enthält die Standardfunktionalität plus Geo-Queries, um zu prüfen, ob sich ein IoT-Node innerhalb oder außerhalb eines Geofence befindet. Empfohlen für Tracking-Anwendungsfälle.
- General Timer and Geo Query – Kombiniert Timer und Geo-Queries. Nützlich in Tracking-Szenarien, in denen sowohl Geofence-Logik als auch zeitbasierte Steuerung benötigt werden – zum Beispiel, um einem Tracker zu erlauben, einen Geofence nur während bestimmter Zeiträume zu verlassen.
Jeder Connector hat einen Default Flow, aber Flows können auch individuell pro IoT-Node zugewiesen werden.
General Timer Flow
Der General Timer Flow wird verwendet, um zeitbasierte Bedingungen in die Alarmlogik einzuführen. Wenn zum Beispiel eine Tür oder ein Fenster geöffnet und nicht innerhalb eines festgelegten Zeitraums wieder geschlossen wird, wird ein Alarm ausgelöst. Ähnlich verhält es sich, wenn eine Temperatur einen definierten Schwellenwert überschreitet und nicht innerhalb einer bestimmten Zeit wieder normal wird – dann tritt ein Alarmereignis auf.
Einen General Timer einrichten
Um General Timers zu verwenden, sind zwei Komponenten erforderlich:
-
General Timer Flow
Dies ist ein Standard-Flow, der nach der Ausführung des Translator Service prüft, ob ein Timer starten soll.
Wenn der Timer abläuft, erhält der IoT-Node ein Update-Ereignis. -
General Timer Translator
Ähnlich wie ein regulärer Alarmübersetzer enthält dieser Übersetzer Alarmschwellenwerte und Hysterese.
Anstatt jedoch direkt einen Alarm auszulösen, steuert er die Timer-Funktionalität.
Häufige Anwendungsfälle
- Türen oder Fenster, die zu lange offen gelassen werden
- Messwerte, die vorübergehend einen Schwellenwert überschreiten können, aber innerhalb einer definierten Zeit wieder normal werden müssen
- Jedes Szenario, das einen zeitbasierten Filter erfordert, bevor eine Warnung oder Aktion ausgelöst wird
General Geo Query Flow
Der General Geo Query Flow arbeitet zusammen mit dem Location Service – unter Verwendung von GPS-, WLAN- oder BLE-Daten –, um zu bestimmen, ob sich ein IoT-Node innerhalb oder außerhalb eines Geofence befindet.
Diese Abfrage wird jedes Mal ausgeführt, wenn ein IoT-Node (typischerweise ein Tracker) ein neues Standortereignis meldet.
Geofences können sowohl Outdoor als auch Indoor sein.
Indoor-Geofences enthalten eine Eigenschaft namens floorIndex, die einer bestimmten Stockwerksebene zugeordnet ist, um den Tracker genau zu lokalisieren.
Geofence-Funktionen aktivieren
-
General Geo Query Flows verwenden
Weisen Sie den General Geo Query Flow den IoT-Nodes zu, die an der Geofencing-Logik teilnehmen sollen. -
Geofence-Generic-Nodes erstellen
Diese Nodes dienen als Referenzpunkte für Geofences und helfen dabei, zu visualisieren, wie viele Tracker sich in jedem befinden.
Fügen Sie den Übersetzergeneral-geofencezu den Geofence-IoT-Nodes hinzu. -
Geofences erstellen
Definieren Sie Geofences direkt auf der Karte oder über Map-Widgets in Dashboards, die geogemappte Grundrisse verwenden.
Verwenden Sie die_iddes generischen Geofence-Nodes als Referenz-Node in jedem Geofence.
General Geo Timer and Query Flow
Kombiniert Timer und Geo-Queries. Nützlich in Tracking-Szenarien, in denen sowohl Geofence-Logik als auch zeitbasierte Steuerung benötigt werden – zum Beispiel, um einem Tracker zu erlauben, einen Geofence nur während bestimmter Zeiträume zu verlassen.
Um dies zu aktivieren, verwenden Sie die obigen Anweisungen für General Timer und General Geo Query Flow zusammen.
Mehr erfahren
- Schulungsmaterial für Standard-Flows
- Benutzerhandbuch für Flows
- Entwicklerhandbuch für Geofences
Schritt 11 - Benutzerdefinierte Übersetzer
Die Plattform ermöglicht es Ihnen, Ihre eigenen benutzerdefinierten Übersetzer zu entwickeln und hochzuladen. Dies ermöglicht es Ihnen, die volle Leistung der Plattform zu entfalten. Ein Übersetzer kann alles sein, von einem kleinen Skript, das einfache Berechnungen durchführt, bis zu Tausenden von Codezeilen, die fortgeschrittene Datenaggregation und KPI-Generierung (Key Performance Indicator) handhaben. Beim Aufbau eines IoT-Anwendungsfalls ist es oft am besten, mit der Definition des gewünschten Ergebnisses zu beginnen – was Sie messen möchten und wie Erfolg bewertet wird. Hier kommen benutzerdefinierte Übersetzer ins Spiel. Sie ermöglichen es Ihnen, die zur Leistungsverfolgung benötigten KPIs zu berechnen, Aktionen zu automatisieren und operative Exzellenz zu unterstützen. Durch die Verwendung benutzerdefinierter Übersetzer hat die Plattform ihre Fähigkeit unter Beweis gestellt, groß angelegte und hochkomplexe Systeme zu verwalten – wie zum Beispiel Asset Management an Flughäfen –, bei denen detailliertes KPI-Tracking und strenge Compliance-Anforderungen unerlässlich sind. Benutzerdefinierte Übersetzer ermöglichen eine präzise Kontrolle über die Datenverarbeitung und machen es möglich, anspruchsvolle betriebliche und regulatorische Standards in realen Einsätzen zu erfüllen.
Arten von Übersetzern
Es gibt mehrere integrierte Übersetzertypen, die jeweils für bestimmte Anwendungsfälle konzipiert sind:
-
Hardware-Übersetzer (Decoder):
Dekodieren komprimierte oder proprietäre Sensor-Payloads in lesbare Messwerte. Dies sind die häufigsten Übersetzer. -
Alarmübersetzer:
Überwachen eingehende Daten anhand von Schwellenwerten. Enthalten oft Logik für Hysterese, um Falschmeldungen zu reduzieren. -
Berechnungen:
Handhaben Einheitenumrechnungen, abgeleitete Metriken (wie Volumen oder Schimmelwachstum) und mathematische Transformationen. -
Datenfreigabe-Übersetzer:
Teilen Messwerte zwischen IoT-Nodes – oft verwendet, um Daten zu spiegeln oder weiterzuleiten. -
Benutzerdefinierte Übersetzer:
Implementieren fortgeschrittene Logik zur Berechnung von KPIs oder zur Handhabung von Abhängigkeiten mehrerer Datenquellen.
Datenweitergabe über "Additional Device Update"
Eine Schlüsselfähigkeit von Übersetzern ist die Möglichkeit, Daten über IoT-Nodes hinweg zu teilen, unter Verwendung des Mechanismus Additional Device Update. Dies ermöglicht die Weitergabe von Roh-, aggregierten oder berechneten Daten in der gesamten Plattform und eröffnet leistungsstarke Anwendungsfälle, wie zum Beispiel:
- Trennung von Netzwerkqualitätsdaten von Sensor-Payloads für sauberere Klassifizierung und Analyse.
- Berechnung, wie viele Geräte an einem bestimmten Standort zu einem beliebigen Zeitpunkt anwesend sind.
- Verfolgung, wie viele Geräte über alle Standorte hinweg in Echtzeit anwesend sind.
- Bestimmung der Besuchshäufigkeit für bestimmte Bereiche oder Zonen.
- Generierung von zusammengesetzten KPIs basierend auf Daten von mehreren Sensoren und Quellen.
- Zusammenfassung systemweiter KPIs unter Verwendung atomarer Updates, um Datenkonsistenz über die Datenbank hinweg sicherzustellen.
Diese Funktionen machen Übersetzer zu einem leistungsstarken Werkzeug bei der Skalierung und Automatisierung komplexer IoT-Systeme und unterstützen eine Vielzahl fortgeschrittener Anwendungsfälle. Wenn Sie Hilfe beim Einstieg in benutzerdefinierte Übersetzer benötigen oder Zugriff auf Referenzimplementierungen wünschen, konsultieren Sie das Entwicklerhandbuch oder wenden Sie sich an Ihren technischen Support-Ansprechpartner.
Schritt 12 - Benutzerdefinierte Data Flows
Die Plattform unterstützt angepasste Data Flows, die es ermöglichen, eingehende Daten je nach erforderlicher Verarbeitung an verschiedene Komponenten weiterzuleiten. Dies ermöglicht eine feingranulare Kontrolle darüber, wie Daten verarbeitet werden – ob sie Übersetzung, Speicherung, regelbasierte Aktionen oder direkte Weiterleitung benötigen. Genau wie Übersetzer laufen benutzerdefinierte Data Flows in einer sicheren Sandbox-Umgebung, um sicherzustellen, dass nur sicherer, verifizierter Code innerhalb der Plattform ausgeführt wird.
Beispielanwendungsfall
Stellen Sie sich ein Szenario vor, in dem ein Sensor hochfrequente Daten sendet, diese Daten aber keine komplexe Verarbeitung erfordern. In diesem Fall wäre es ineffizient, sie über den Translator Service, Calculations oder die Rule Engine zu leiten. Stattdessen könnte ein benutzerdefinierter Data Flow erstellt werden, um diese Dienste zu umgehen und die Daten direkt an die Datenbank weiterzuleiten. Dies reduziert den Overhead, verbessert die Leistung und erhöht die Fähigkeit der Plattform, große Mengen hochfrequenter Daten zu verarbeiten. Umgekehrt können andere Datenströme fortgeschrittene Berechnungen, Ereigniserkennung oder benutzerdefinierte Logik erfordern – in diesem Fall sollten die Daten wie gewohnt über die Komponenten Translator Service, Calculations und Rule Engine geleitet werden.
Mit benutzerdefinierten Data Flows können Sie genau festlegen, wie jede Art eingehender Daten verarbeitet wird, um optimale Leistung und Flexibilität über verschiedene IoT-Anwendungsfälle hinweg sicherzustellen.
Aktuelle und zukünftige Fähigkeiten
Derzeit müssen benutzerdefinierte Data Flows vom Sensative-Team implementiert werden. Zukünftige Versionen von Yggio werden jedoch die Möglichkeit bieten, benutzerdefinierte Data Flows direkt über die Rule Engine zu entwerfen und bereitzustellen, was ein nahtloses Konfigurationserlebnis für Systemintegratoren und fortgeschrittene Benutzer bietet.